Qwen3.8-27B 正式开源,GGUF 格式,可以适配多种不同尺寸的显存——最低 8G 显存就能跑。另外它还有越狱无审查版本,最低支持 4G 显存。
这篇把整个本地部署流程走一遍:下载模型、装 llama.cpp、用一键启动脚本跑起来,最后对接 Hermes Agent。
一、Qwen3.8-27B 开源模型
目前量化的 Qwen3.8-27B 模型总共有 21 个,格式为 GGUF,可以适配多种不同尺寸的显存大小,最低支持 8G 显存。
不同量化档位的体积和显存需求差别很大。下表列出了全部档位的文件大小、权重占用,以及 8K / 32K 上下文下各自需要的显存,最后一列是对应的建议显卡:
| 量化 | 文件大小 | 权重(GiB) | 8K 上下文 | 32K 上下文 | 建议显卡 |
|---|---|---|---|---|---|
| UD-IQ2_XXS | 9.01 GB | 8.4 | 9.9 | 12.4 | 8~12G(3060 12G / 5070) |
| UD-IQ2_M | 10.3 GB | 9.6 | 11.1 | 13.6 | 12G(32K 需降 ctx) |
| UD-Q2_K_XL | 10.7 GB | 10.0 | 11.5 | 14.0 | 12G 极限 / 16G 舒适 |
| UD-IQ3_XXS | 11.9 GB | 11.1 | 12.6 | 15.1 | 16G(4060Ti 16G / 5060Ti 16G) |
| Q3_K_S | 12.6 GB | 11.7 | 13.2 | 15.7 | 16G |
| UD-Q3_K_XL | 13.4 GB | 12.5 | 14.0 | 16.5 | 16G 低显存首选 |
| Q3_K_M | 13.8 GB | 12.9 | 14.4 | 16.9 | 16G |
| IQ4_XS | 15.7 GB | 14.6 | 16.1 | 18.6 | 20G / 24G |
| Q4_K_S / Q4_0 | 16.1 GB | 15.0 | 16.5 | 19.0 | 20G(7900XT / 4000 Ada) |
| IQ4_NL | 16.3 GB | 15.2 | 16.7 | 19.2 | 20G |
| Q4_K_M | 17.1 GB | 15.9 | 17.4 | 19.9 | 24G |
| Q4_1 | 17.5 GB | 16.3 | 17.8 | 20.3 | 24G |
| UD-Q4_K_XL | 17.9 GB | 16.7 | 18.2 | 20.7 | 24G 全场最佳性价比 |
| Q5_K_S | 19.3 GB | 18.0 | 19.5 | 22.0 | 24G(3090 / 4090) |
| Q5_K_M | 19.8 GB | 18.4 | 19.9 | 22.4 | 24G |
| UD-Q5_K_XL | 20.2 GB | 18.8 | 20.3 | 22.8 | 24G 偏紧 / 32G 舒适 |
| Q6_K | 22.9 GB | 21.3 | 22.8 | 25.3 | 24G 仅短上下文 / 32G |
| UD-Q6_K_XL | 25.9 GB | 24.1 | 25.6 | 28.1 | 32G(5090) |
| Q8_0 | 29 GB | 27.0 | 28.5 | 31.0 | 32G 极限 / 48G |
| UD-Q8_K_XL | 31.5 GB | 29.3 | 30.8 | 33.3 | 48G(A6000 / 双卡 24G) |
| BF16(文件夹) | ~54 GB | ~50 | ~52 | ~54 | 80G 或双卡 48G |
下载地址
- HuggingFace:unsloth/Qwen3.8-27B-GGUF
显存低于 8G 的话,可以直接跳到第四步下载越狱模型——越狱版最低支持 4G 显存。
二、下载 llama.cpp
llama.cpp 是本地跑 GGUF 模型的主力工具。Windows 上直接下载官方仓库里编译好的 release 包,解压即用,不需要自己编译。
下载地址
- GitHub:ggml-org/llama.cpp
解压后你会用到其中两个程序:
llama-server.exe—— 启动后提供网页版对话界面llama-cli.exe—— 命令行交互
三、一键启动脚本
手动敲 llama-server 的启动参数比较麻烦——要指定模型路径、上下文长度、GPU 层数(-ngl)等等,参数写错就跑不起来。所以社区做了一个一键启动脚本。
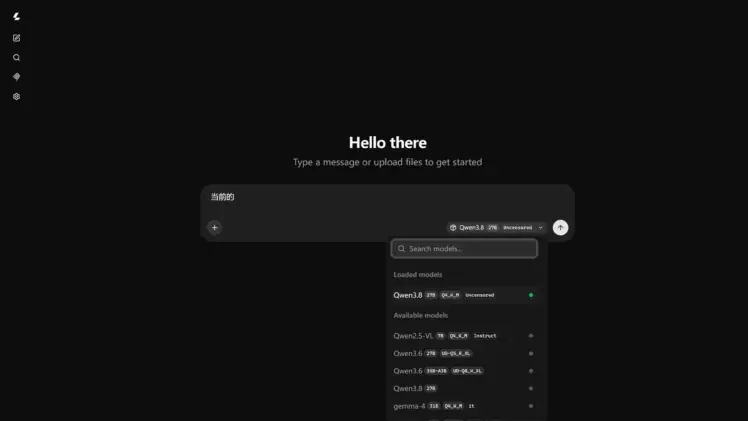
它的作用是:自动识别你当前的电脑硬件配置,并根据你的配置帮你匹配合适的启动参数。同时还支持同时加载多个模型,启动后可以自动切换你需要的模型,比较省事。
脚本启动后,会自动弹出窗口进入 llama.cpp 控制面板,界面上可以随时切换已经加载的模型:
四、越狱模型(无审查)
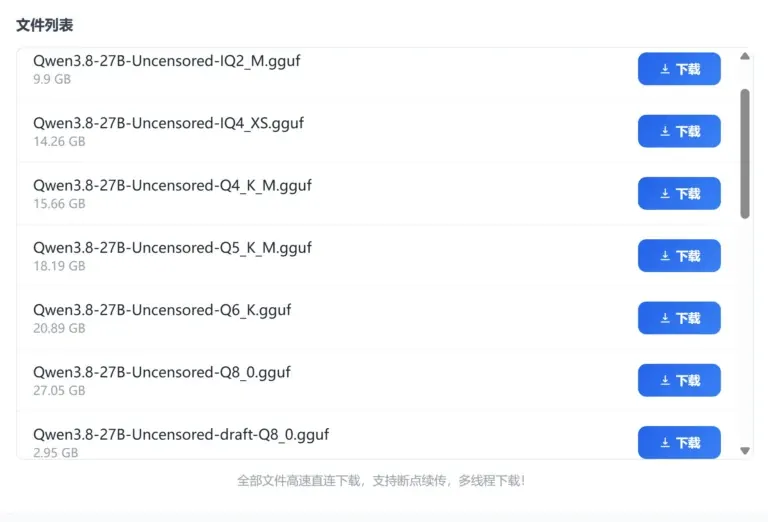
Qwen3.8-27B 现在已经推出了多个真正无审查的越狱模型。如果你想更自由、不受约束和限制,在本地使用越狱模型,那么下方的模型不要错过——最低支持 4G 显存。
下载地址
- HuggingFace:JonathanColetti/Qwen3.8-27B-Uncensored-GGUF
加载越狱模型以后,一些原本会被拒绝的请求就可以正常处理了。需要提醒的是:无审查不等于没有风险,模型输出的内容需要你自己判断和承担,尤其是拿它生成脚本、文案或其它可执行的东西时。
五、对接 Hermes Agent
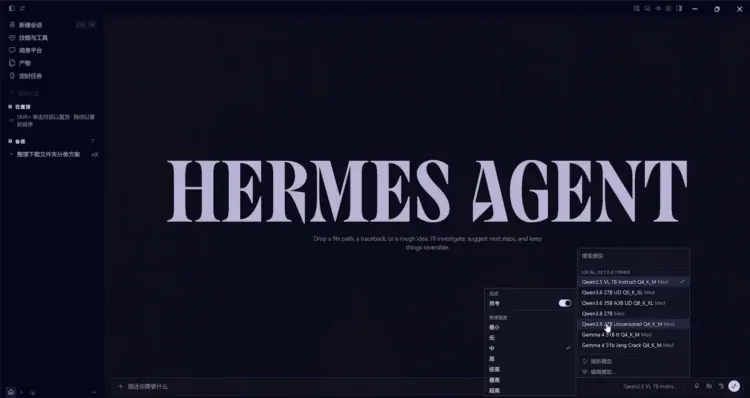
如果你想让本地模型被 Agent 调用,而不是自己在浏览器里手动提问,可以对接 Hermes Agent。
它走的是本地子托管的形式:把 llama-server 在本地暴露的接口接进去,就能在 Agent 里调用这个模型,全程免费、不联网,也不用把模型上传到任何地方。
下载地址
常见问题
显存不够怎么办?
先按上面的表换低一档的量化版本,再把 GPU 层数调低(-ngl 参数)。llama.cpp 支持把一部分层放在 CPU 上跑,只是速度会慢。
8GB 显存选哪个?
看表里「建议显卡」那一列。8~12G 选 UD-IQ2_XXS;12G 选 UD-IQ2_M;16G 优先 UD-Q3_K_XL;24G 直接上 UD-Q4_K_XL。
端口被占用怎么办?
llama-server 默认用 8080,如果被别的程序占了,启动参数加 --port 8081 换一个即可。
怎么直接下载,不用网盘?
上面给的 HuggingFace 与 GitHub 都是官方直连地址,浏览器直接下,或用 huggingface-cli download 都行,速度取决于你的网络。
本文整理自公开的模型发布信息与本地实测流程,仅供学习参考。模型的下载与使用请遵守其原始许可证。
赞赏支持